

Дата обновления статьи: 13.08.2026
Аварийный простой сервера приводит к серьезным финансовым и репутационным потерям бизнеса. Почему происходят сбои, как вовремя обнаружить аппаратные ошибки, утечки памяти или активность OOM Killer? В статье разбираются виды ошибок от 502 Bad Gateway до Kernel Panic, приводится пошаговая экспресс-диагностика через консольные команды SSH, а также эффективные методы защиты: от непрерывного мониторинга и бэкапов до балансировки нагрузки и настройки systemd.
Содержание
- Виды недоступности и индикаторы сбоя
- 5 главных причин падения серверов
- Что делать, если сервер упал: экспресс-диагностика
- Как предотвратить падение сервера: комплексная система защиты
- Экспресс-чеклист отказоустойчивости инфраструктуры
- Часто задаваемые вопросы
Виды недоступности и индикаторы сбоя
Падение сервера не всегда означает полный отказ аппаратной части. В зависимости от уровня модели OSI и характера неисправности сбой проявляется по-разному.
| Код ошибки / Симптом | Уровень сбоя | Вероятная причина |
| 502 Bad Gateway | L7 (Прикладной) | Сервер бэкенда (PHP-FPM, Node.js, Python) упал или не успевает отвечать веб-серверу (Nginx). |
| 504 Gateway Timeout | L7 (Прикладной) | Таймаут обработки запроса: зависшие SQL-запросы, внешние API-запросы или перегрузка процессора. |
| 500 Internal Server Error | L7 (Прикладной) | Ошибка в коде приложения, фатальный сбой скрипта, некорректный синтаксис .htaccess или конфигурации. |
| Connection Refused / Timeout (SSH) | L4 (Транспортный) | Сбой демона SSHd, переполнение таблицы соединений, брандмауэр (iptables/nftables) заблокировал порт. |
| Destination Host Unreachable | L3 (Сетевой) | Проблемы с маршрутизацией, сбой сетевой карты (NIC), проблемы на стороне дата-центра. |
| Полное отсутствие отклика (No Ping) | L1–L3 (Физический/Сетевой) | Отключение питания, аппаратный завис (Kernel Panic), разрушение файловой системы, массированная L3/L4 DDoS-атака. |
5 главных причин падения серверов

1. Аппаратные сбои (Hardware Failures)
Серверное оборудование работает в режиме 24/7 под высокой нагрузкой. К критическим аппаратным точкам отказа относятся:
- Накопители (SSD/NVMe/HDD): деградация ячеек памяти, выработка ресурса TBW, появление битых секторов. При выходе из строя накопителя без настроенного RAID-массива система немедленно переходит в режим
read-onlyили полностью теряет файловую систему. - Оперативная память (RAM): ошибки в модулях RAM приводят к спонтанным перезагрузкам и ошибкам сегментации ядра – Kernel Panic.
- Система питания и охлаждения: выход из строя одного из блоков питания (при отсутствии дублирования PDU) или перегрев процессора выше критической отметки с последующим экстренным отключением платы.
2. Нехватка ресурсов и работа Linux OOM Killer
При скачке посещаемости или неоптимизированных запросах система исчерпывает доступную оперативную память. Когда объем свободного RAM и Swap стремится к нулю, ядро Linux активирует механизм Out-Of-Memory (OOM) Killer.
OOM Killer принудительно завершает самый «прожорливый» процесс (часто это MySQL/PostgreSQL или PHP-FPM), чтобы предотвратить крах всей системы. В результате веб-сервер остается активным, но начинает отдавать клиентам ошибки 502 Bad Gateway или 500 Internal Server Error.
3. Кибератаки (DDoS и брутфорс)
Вредоносный трафик дестабилизирует инфраструктуру на разных уровнях:
- L3/L4 DDoS (SYN-flood, UDP-flood): забивают полосу пропускания сетевого канала и истощают ресурсы сетевого стека операционной системы.
- L7 DDoS (HTTP-flood): имитируют поведение легитимных пользователей, отправляя сложные запросы к базе данных или тяжелым страницам сайта, что полностью утилизирует CPU и RAM бэкенд-серверов.
Профессиональная защита от DDoS-атак
Оградите свой сервер от ботнетов, объемных штормов и веб-атак. Обеспечьте непрерывную доступность проекта 24/7 без риска ухода в «черную дыру».
- Отражение угроз на уровнях L3, L4 и L7 (WAF)
- Мониторинг сетевого трафика в реальном времени
- Подходит для корпоративных порталов и игр
- Быстрое подключение и круглосуточная поддержка ЦОД
4. Программные ошибки и некорректный конфиг
- Утечки памяти: приложения на Python, Node.js, C++ или неоптимизированные модули CMS постепенно захватывают память без ее последующего освобождения.
- Некорректные обновления и конфиги: внесение синтаксических ошибок в конфигурационные файлы (nginx.conf, my.cnf), несовместимость версий библиотеки после
apt upgradeили блокировка потоков баз данных.
5. Человеческий фактор и внешняя инфраструктура
Аварии на магистральных каналах связи дата-центра, ошибки системных администраторов при правке сетевых интерфейсов или правил фаервола (iptables -F), а также исчерпание свободных дисковых дескрипторов.
Что делать, если сервер упал: экспресс-диагностика

Если сервер перестает отвечать, необходимо пошагово выполнить базовые команды диагностики через SSH или KVM/VNC-консоль хостинга.
Шаг 1: проверка доступности сети
Определяем, на каком этапе теряются пакеты:
# Проверка базового отклика
ping -c 5 YOUR_SERVER_IP
# Диагностика маршрута и потерь на узлах
mtr —report YOUR_SERVER_IP
Шаг 2: экспресс-анализ ресурсов (CPU, RAM, Swap)
Если SSH доступен, проверяем утилизацию процессора и памяти:
# Просмотр нагрузки на CPU и процессов в реальном времени
top -b -n 1 | head -n 20
# Проверка оперативной памяти и Swap (в мегабайтах)
free -m
Шаг 3: проверка дискового пространства и Inodes
Сервер часто «зависает» из-за переполнения диска логами или файлами сессий. Если диск заполнен на 100%, базы данных перестают записывать временные файлы и падают.
# Проверка свободного места на монтированных дисках
df -h
# Проверка количества свободных файловых дескрипторов (Inodes)
df -i
Шаг 4: поиск работы OOM Killer в системных логах
Проверяем, не аварийно ли ядро завершило процессы из-за нехватки RAM:
# Поиск событий принудительного завершения процессов по OOM
dmesg -T | grep -i -E ‘oom|killed’
# Чтение логов за последние 30 минут через journalctl
journalctl —since «30 min ago» -p err
Шаг 5: проверка статуса ключевых служб
# Статус веб-сервера и базы данных
systemctl status nginx
systemctl status mysql # или postgresql, php8.2-fpm
Как предотвратить падение сервера: комплексная система защиты
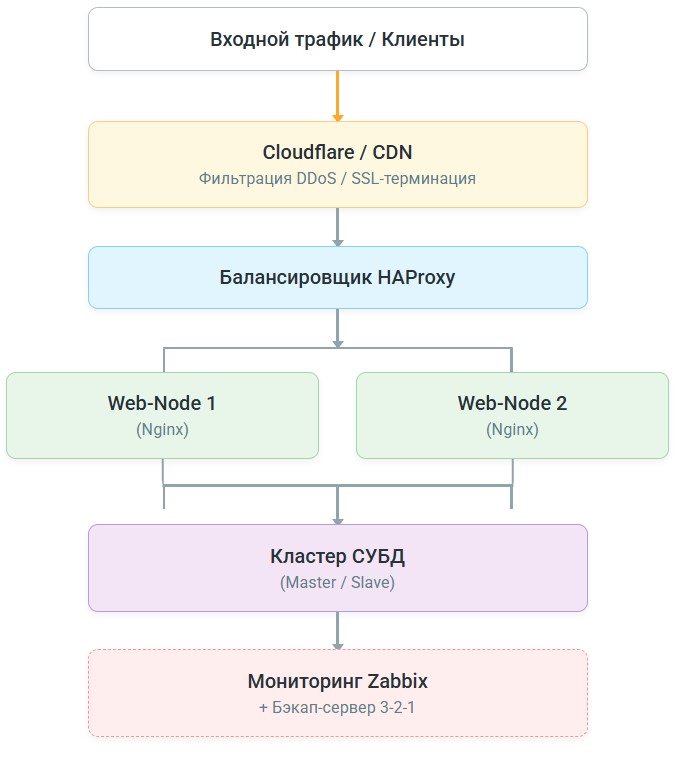
Предотвращение аварий строится на четырех столпах: мониторинге, отказоустойчивой архитектуре, резервировании и регулярном обслуживании.
1. Непрерывный мониторинг и алертинг
Необходимо фиксировать аномалии до того, как они приведут к падению:
- Инструменты: Zabbix, Prometheus + Grafana, Datadog.
- Метрики для контроля: загрузка CPU (>80% в течение 5 мин), использование RAM (>85%), свободное место на диске (<15%), количество активных соединений СУБД, статус SMART накопителей.
- Алертинг: настройка мгновенных уведомлений дежурной инженерии через Telegram API, PagerDuty или SMS.
2. Балансировка нагрузки и горизонтальное масштабирование
Для распределения входящего трафика между несколькими узлами:
- Использование HAProxy или Nginx в качестве Reverse Proxy и балансировщика.
- Подключить защиту от DDoS-атак и кэширования статики.
- Использование контейнеризации (Docker, Kubernetes) для автоматического перезапуска упавших сервисов и масштабирования POD-ов при пиковых нагрузках.
3. Резервирование данных по правилу 3-2-1
Резервное копирование не предотвращает падение, но сводит к минимуму время простоя (RTO) и потерю данных (RPO):
- 3 копии данных (оригинал + 2 бэкапа).
- 2 различных типа носителей (локальный хранилище + удаленный S3-бэкап).
- 1 копия должна храниться в абсолютно другом дата-центре (Offsite storage).
- Регулярное тестовое восстановление: Бэкап считается валидным только после успешной тестовой сборки из него рабочей среды.
4. Оптимизация ПО и плановое обслуживание
- Настройка лимитов ресурсов в systemd и конфигах веб-серверов (worker_processes, max_connections, pm.max_children).
- Своевременная установка обновлений безопасности ОС и компонентов среды.
- Тюнинг СУБД (например, настройка innodb_buffer_pool_size в MySQL под доступный объем RAM).
Экспресс-чеклист отказоустойчивости инфраструктуры
Для проверки готовности сервера к штатным и аварийным нагрузкам сверьтесь со следующими пунктами:
- Мониторинг: настроен сбор метрик CPU/RAM/Disk с алертингом в Telegram/PagerDuty.
- Swap-файл: подключен и настроен резервный файл подкачки (с swappiness = 10..20), чтобы предотвратить моментальный удар OOM Killer.
- Бэкапы: настроено ежедневное авторезервирование баз данных и файлов на изолированный S3-сервер.
- RAID-массив: накопители объединены минимум в RAID 1 (зеркалирование) или RAID 10.
- Дисковые лимиты: настроен регулярный ротейт логов (logrotate) и очистка временных директорий.
- Фаервол: закрыты все неиспользуемые порты (ufw / iptables), доступ по SSH разрешен только по ключам.
- Защита от сбоев питания: сервер имеет два блока питания, подключенных к независимым вводам АВР дата-центра.
Часто задаваемые вопросы
Для чистого ванильного сервера на 2–4 человека достаточно 4 ГБ ОЗУ. Для комфортной игры с плагинами на 5–10 человек требуется 6–8 ГБ, а для крупных сборок с модами на Fabric/Forge – от 10–12 ГБ.
Откройте файл server.properties, найдите строку online-mode=true и измените значение на online-mode=false. После этого обязательно установите плагин авторизации AuthMeReloaded, чтобы предотвратить несанкционированный вход под никнеймами администраторов.
Установите на ваш сервер PaperMC или Purpur связку плагинов GeyserMC и Floodgate. Geyser транслирует сетевые пакеты между различными версиями игры, а Floodgate позволяет игрокам с Bedrock подключаться без покупки Java-аккаунта.
Используйте сервис Playit.gg. Скачайте его клиент на ваш ПК, запустите параллельно с сервером, и программа выдаст вам бесплатный домен вида name.ply.gg для подключения через защищенный сетевой туннель.
Откройте консоль запущенного сервера (окно start.bat на ПК или консоль в панели хостинга) и введите команду op ваш_ник (без слэша / в начале). В чате появится подтверждение, после чего игрок получит статус оператора и доступ ко всем администраторским командам в игре.
Остановите сервер, найдите в его корневой папке директорию world и скопируйте ее в надежное место (или удалите, если старый мир не нужен). Поместите папку с вашей новой картой в корень сервера и переименуйте ее в world, после чего запустите сервер повторно.
